Do elevador ao making of: uma experimentação com OpenRouter, Veo e Seedance
Comecei tentando transformar um storyboard em um microfilme dentro de um elevador. Terminei produzindo também um meta-vídeo em que o personagem fala sobre o próprio processo. No meio disso, encontrei um fluxo útil, custos que exigem critério de uso e limites bem concretos de identidade, duração e moderação.
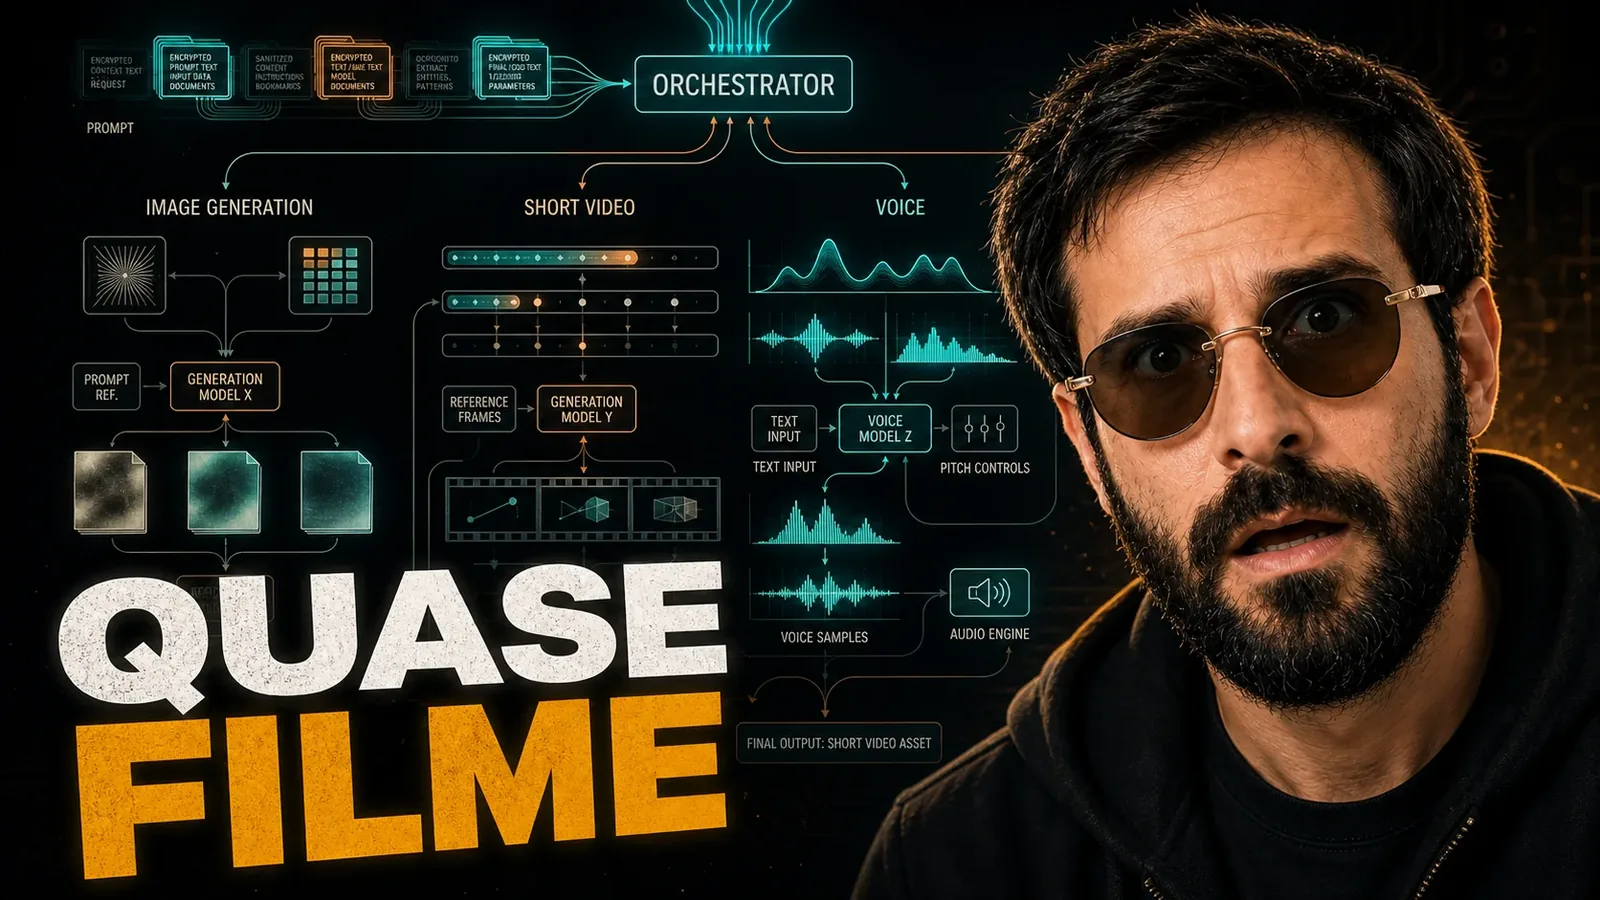
O experimento aconteceu em duas etapas. A primeira foi Entre andares, um microfilme silencioso sobre um homem sozinho no elevador, tentando se recompor antes que as portas se abram. A segunda foi um desdobramento inevitável: fazer um vídeo em que esse mesmo personagem aparece em um estúdio retro-tech falando sobre como o vídeo anterior estava sendo feito.
Em termos de stack, a arquitetura ficou relativamente clara. Usei o OpenRouter como camada de orquestração, o Seedance 2.0 para parte das animações e dos planos mais controlados, o Veo 3.1 Fast para os takes falados e alguns closes mais estáveis, e a ElevenLabs para as narrações em off e testes de voz. O resto foi montagem local.
1. O primeiro alvo foi um curta muito pequeno
O curta do elevador já nasceu com uma vantagem: eu não estava tentando um filme longo, nem um diálogo. Era uma microcena de suspensão, baseada em seis blocos simples. Entrada. Isolamento. Botão. Pulso. Fissura. Recomposição. O formato ajudou. O limite técnico dos modelos também.
Antes de qualquer geração de vídeo, eu já tinha um material-base importante: um storyboard visual fechado. Em vez de improvisar shot a shot desde o início, eu consegui trabalhar com uma sequência relativamente clara de enquadramentos, gestos e transições emocionais.
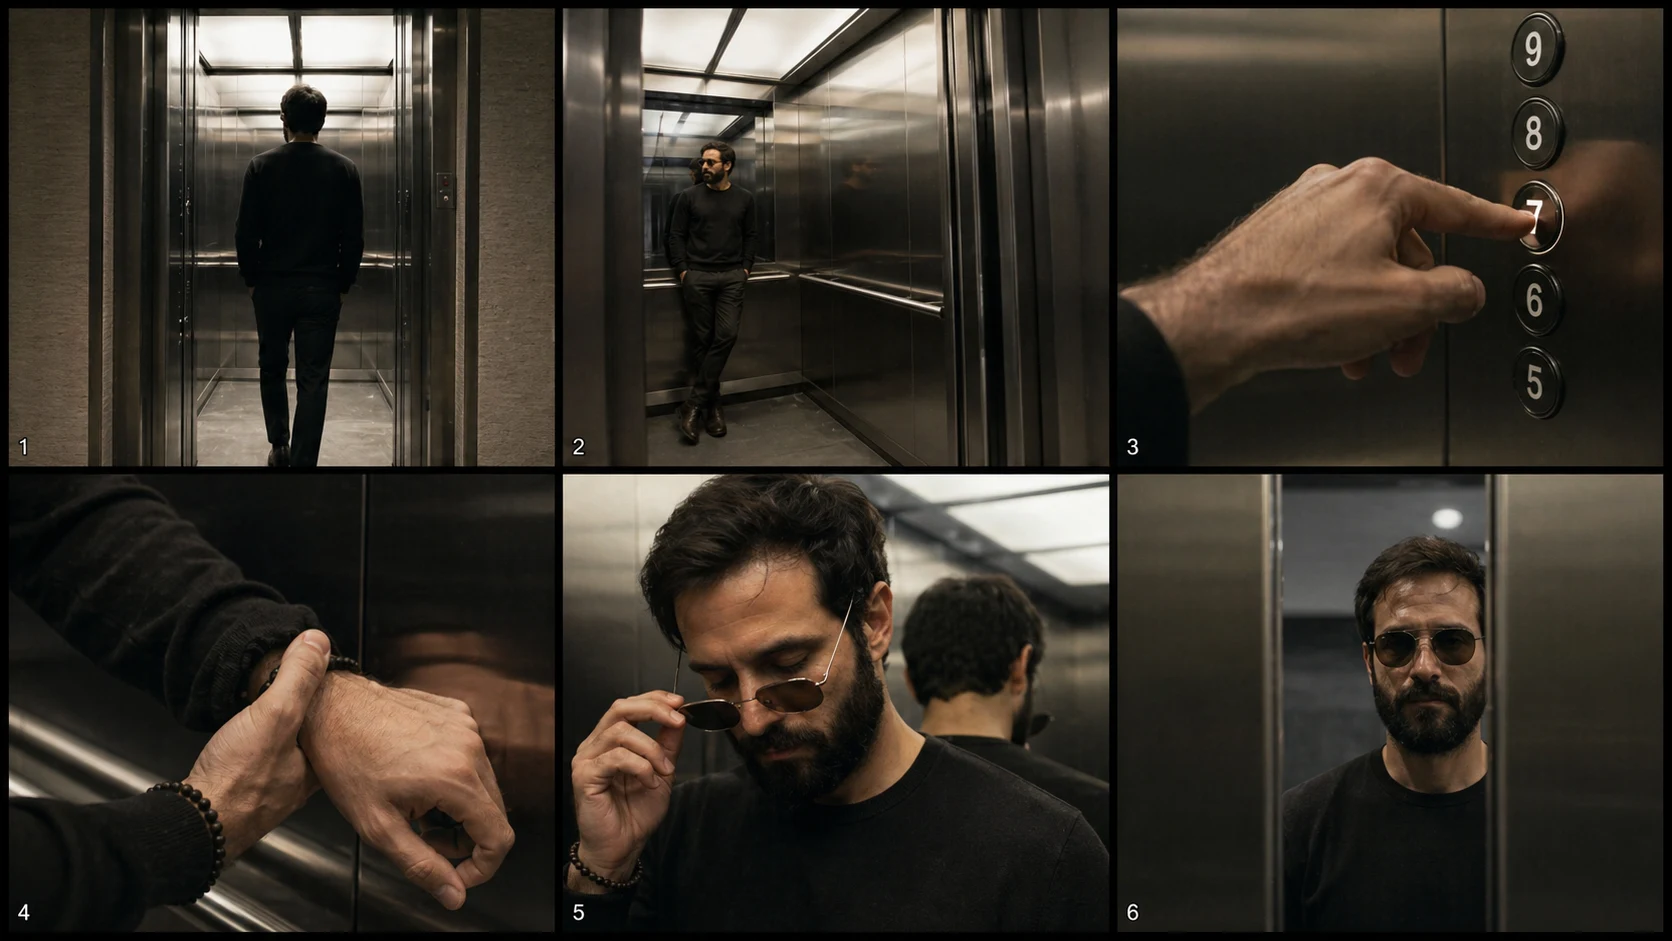
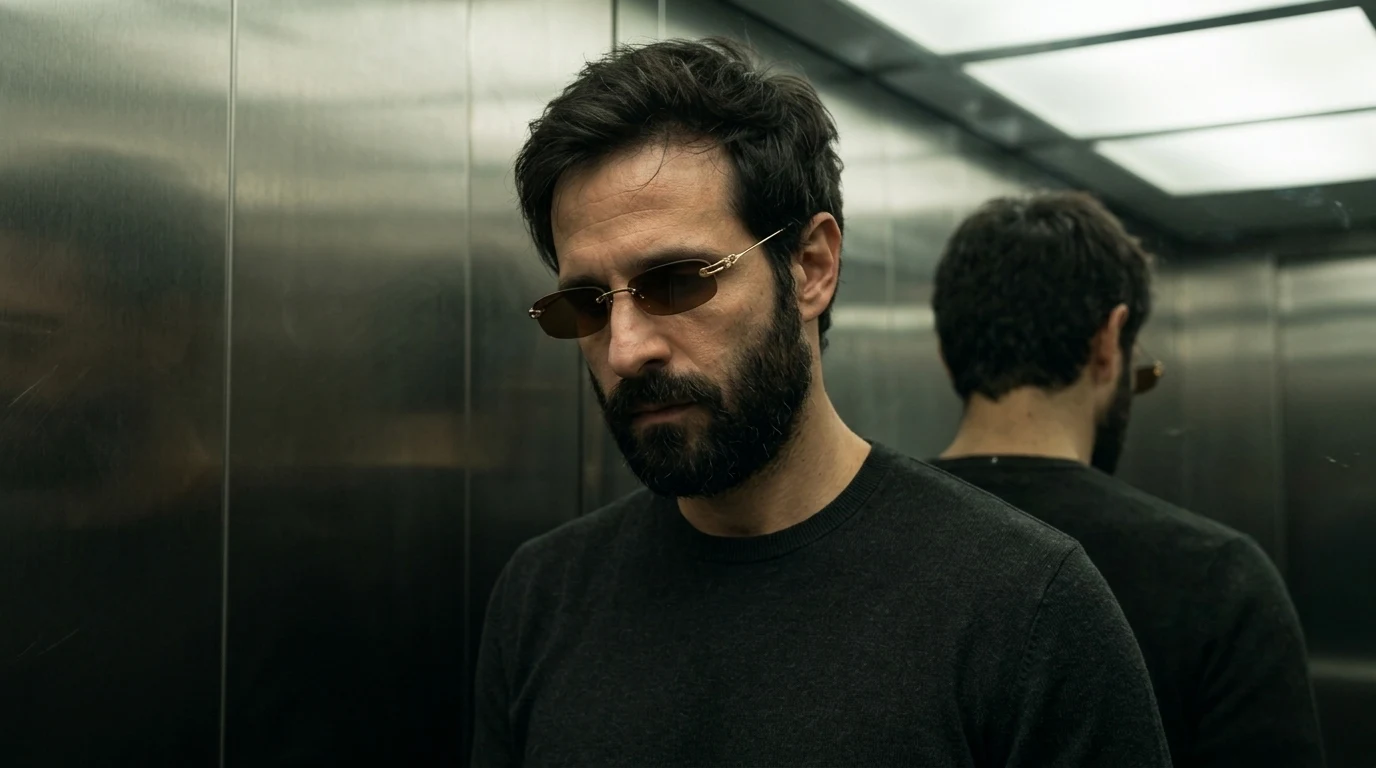
A primeira conclusão prática foi que não valia pedir um vídeo contínuo de vinte ou trinta segundos para um gerador. O caminho mais confiável era quebrar tudo em planos curtos, gerar por shot e deixar a continuidade global para a montagem. Essa lógica ficou ainda mais forte quando os testes começaram a esbarrar em duas coisas: filtros de privacidade e deriva facial.
O Seedance funcionou bem para planos de corpo, atmosfera e detalhe. Já os close-ups faciais acabaram passando melhor no Veo. O curta final de Entre andares ficou com uma estrutura híbrida: quatro shots do Seedance e dois do Veo.
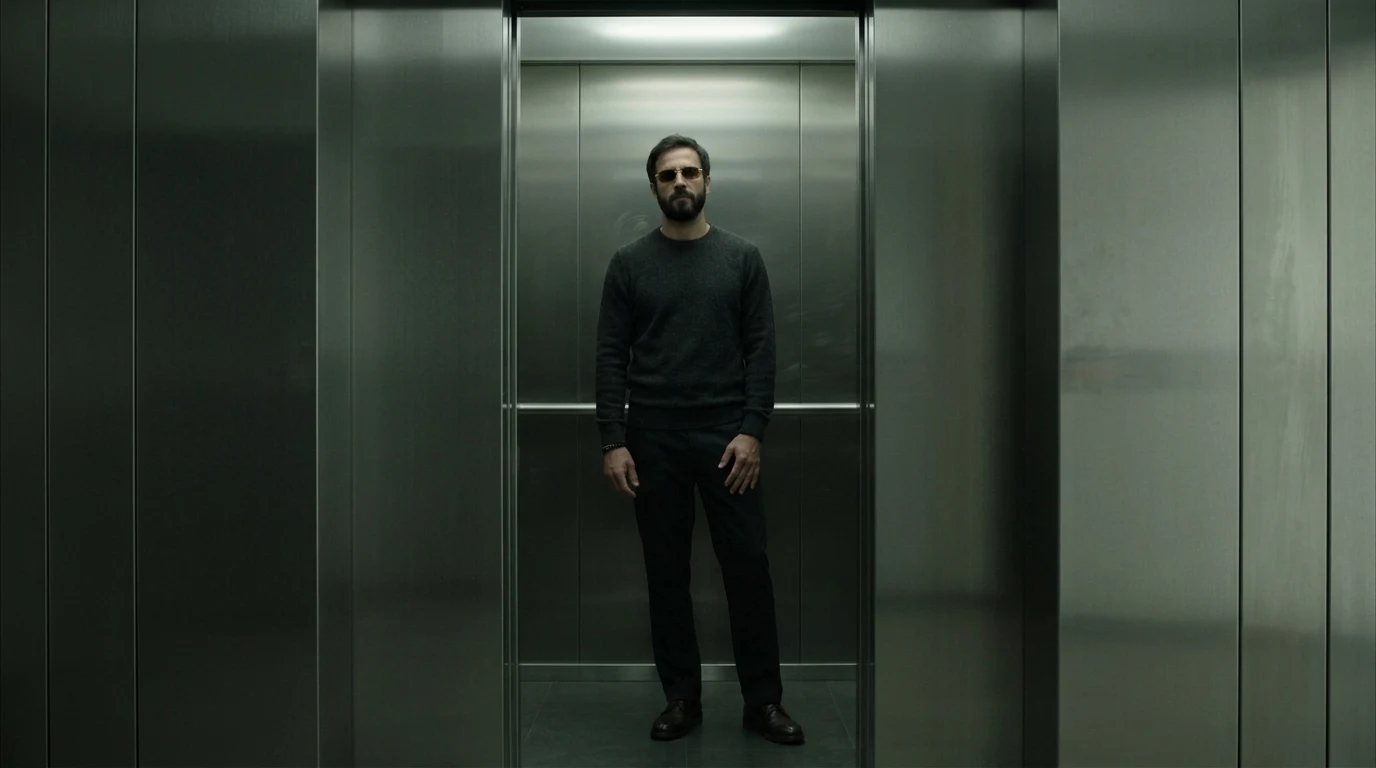
2. O segundo alvo foi mais estranho e mais interessante
Depois do curta, eu quis produzir um vídeo em que o personagem aparecesse falando diretamente para a câmera sobre o próprio processo. Não um making of documental, mas um ensaio audiovisual curto sobre a montagem de um filme com referências, keyframes, OpenRouter, Seedance e Veo.
Essa segunda etapa dependia de um conjunto de imagens-base do personagem. Parte dele veio do pacote do meu gêmeo digital: variações de look, enquadramentos frontais, perfil e sheets intermediárias que serviram para consolidar traços, barba, cabelo, nariz, proporções e presença.
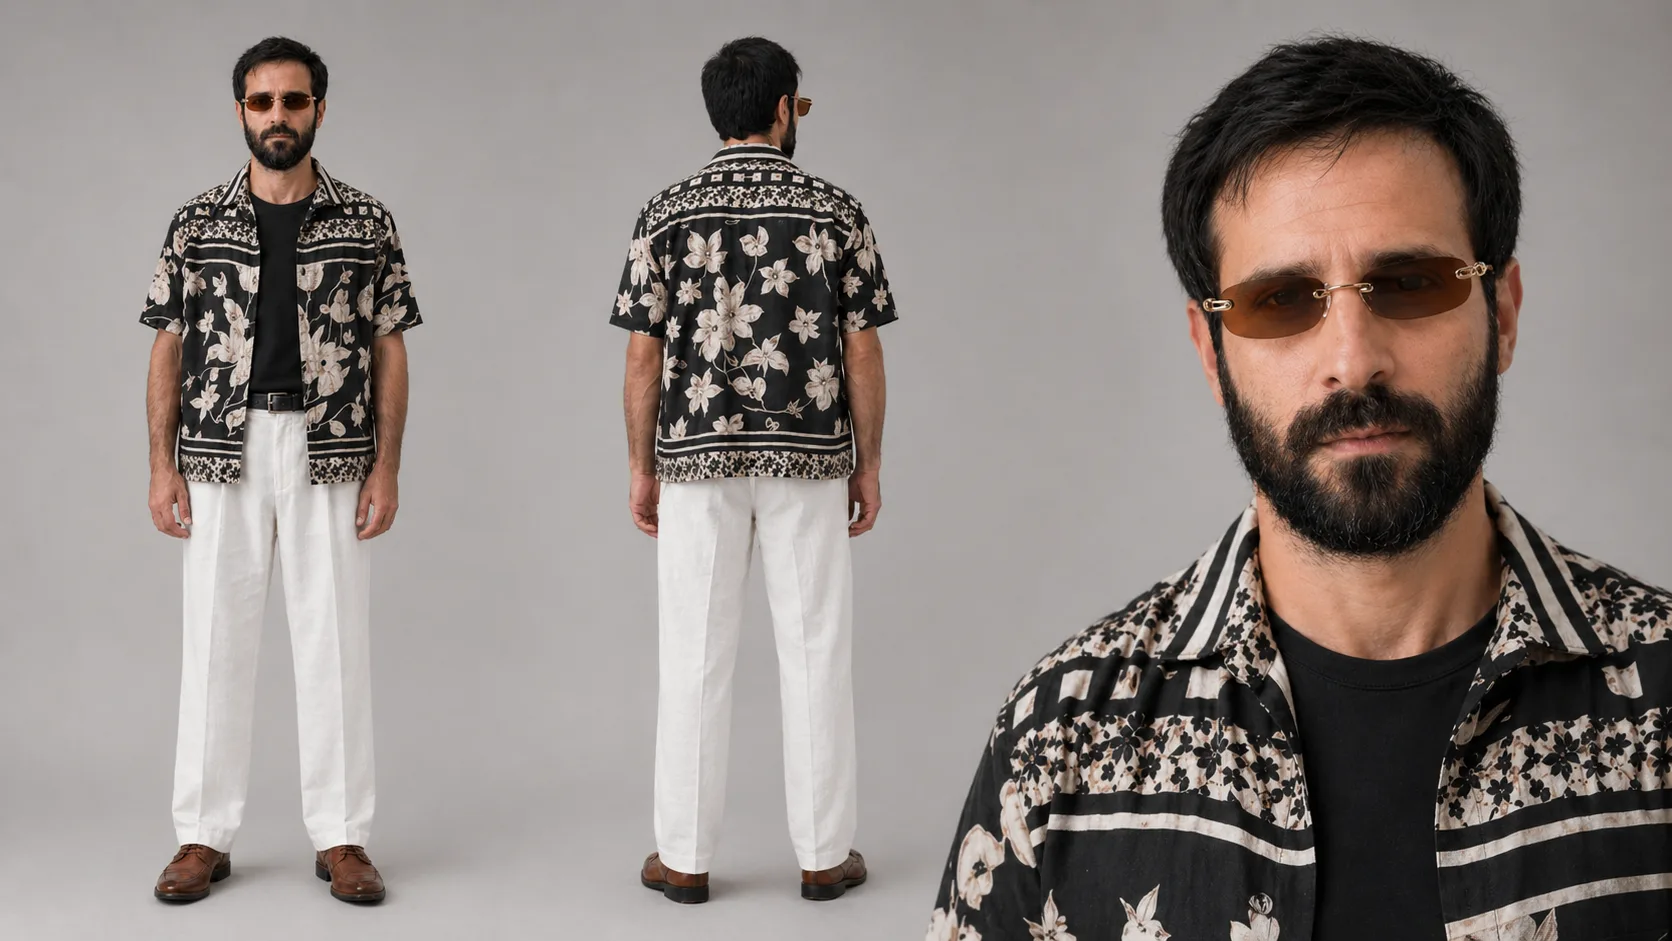
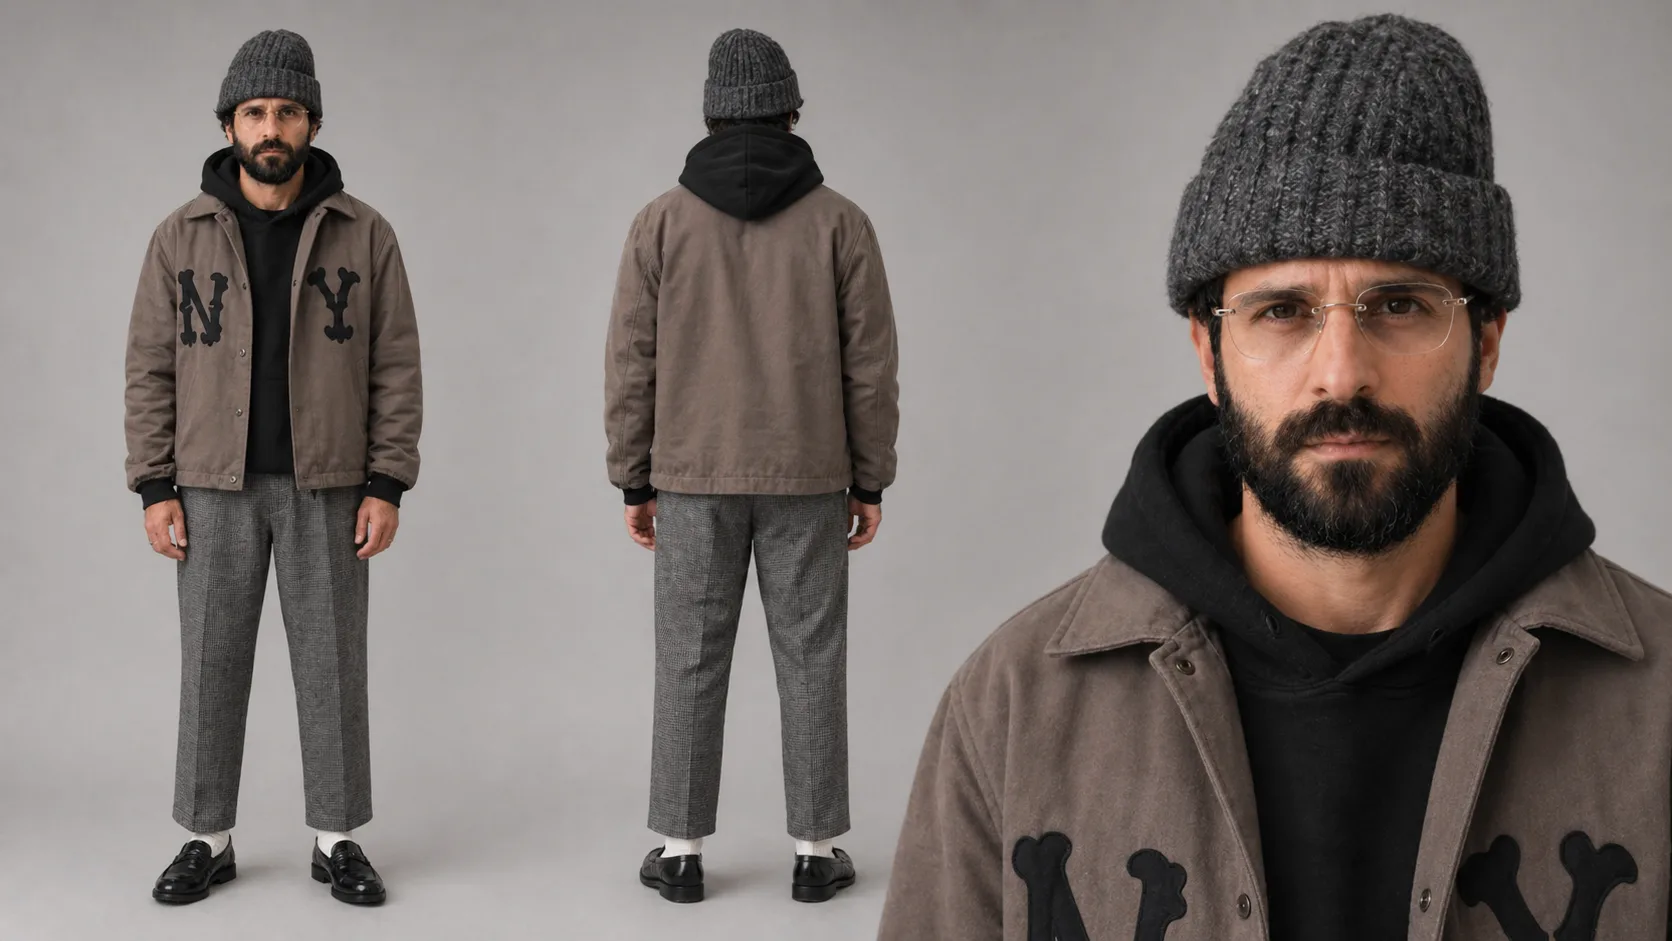
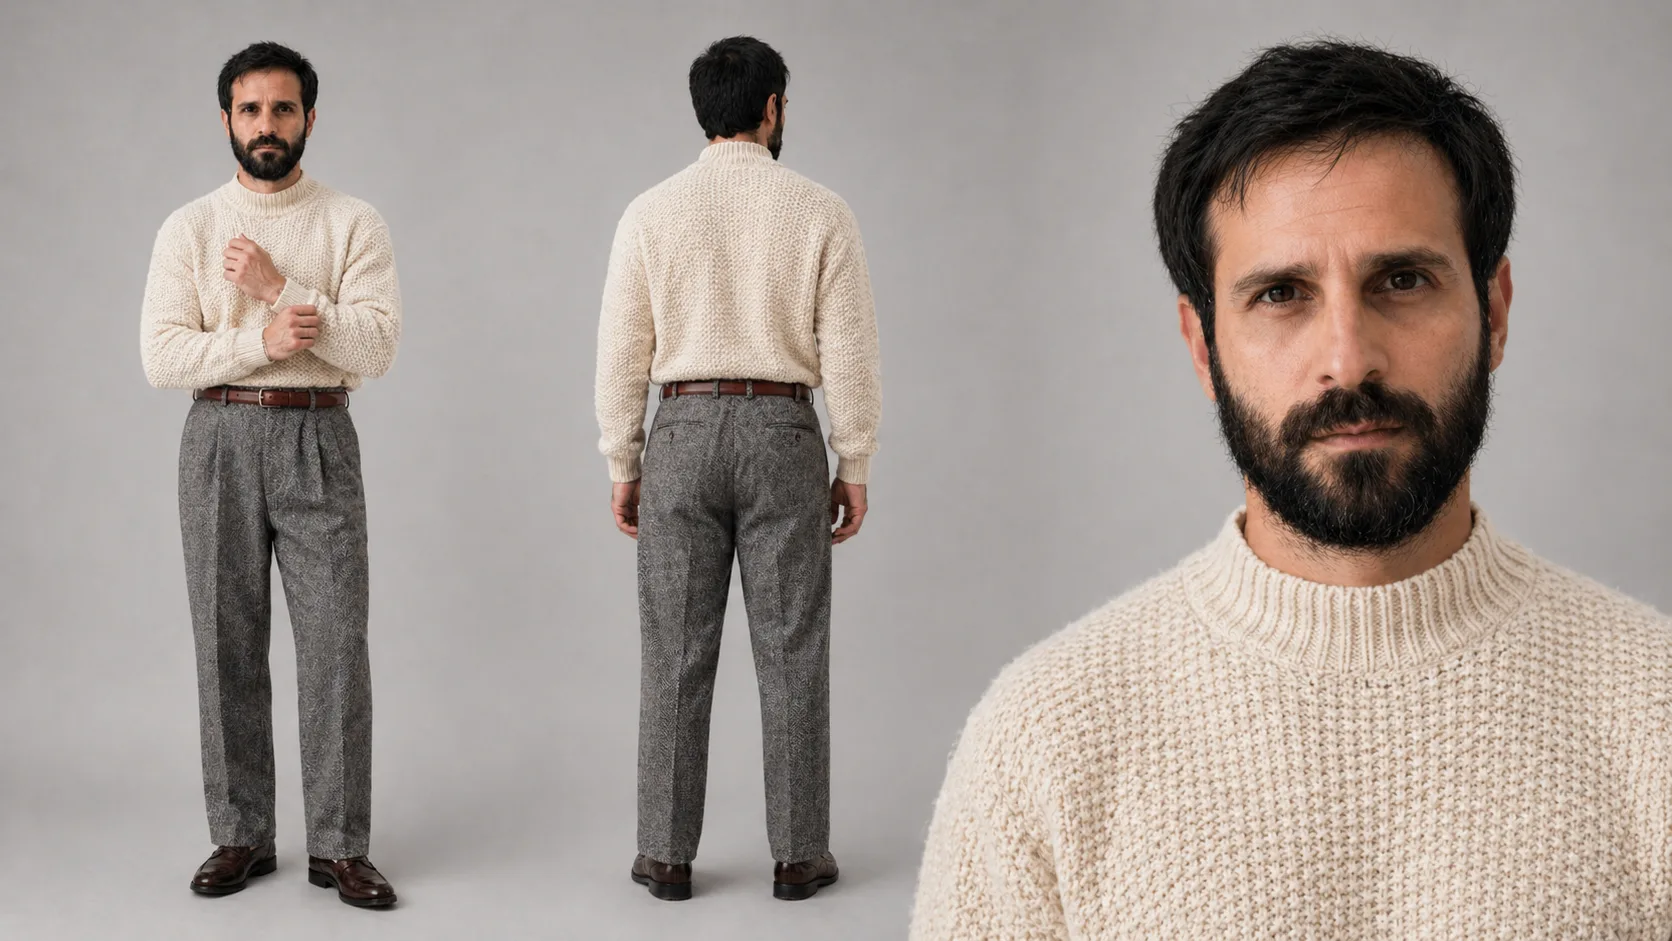
Foi aí que os limites ficaram mais nítidos. O Seedance, via OpenRouter, bloqueava repetidamente qualquer tentativa de usar um rosto realista e reconhecível como base para um talking shot. O erro se repetia em variações de prompt e styling:
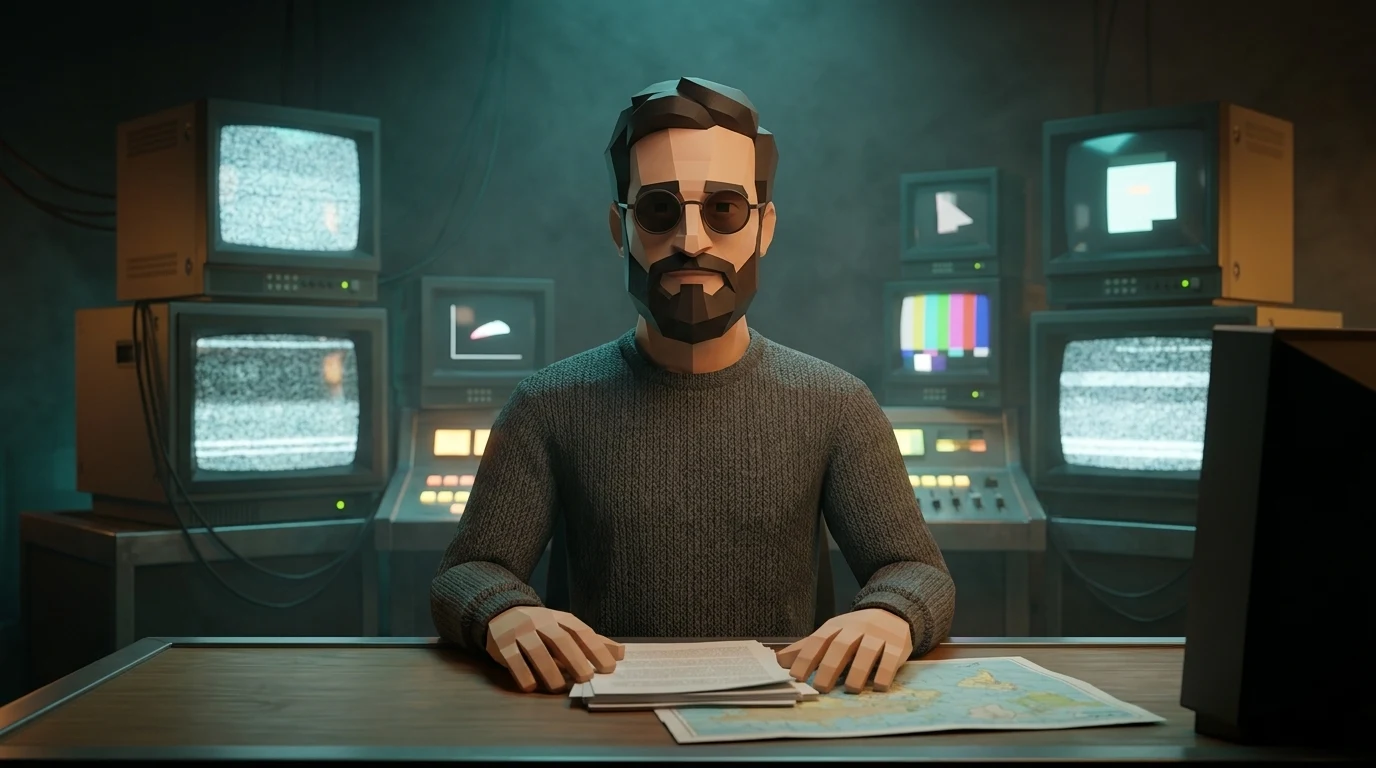
InputImageSensitiveContentDetected.PrivacyInformationTrocar figurino não resolveu. Gerar o rosto com outro modelo antes também não resolveu. Levar esse mesmo personagem para um visual lowpoly 3D resolveu tecnicamente, mas descaracterizou o objetivo do projeto. O que eu queria era manter um personagem próximo de mim, não um avatar genérico.
Mesmo assim, a tentativa lowpoly foi útil porque provou uma coisa: o bloqueio estava muito mais ligado à leitura de “pessoa real identificável” do que à estrutura do pipeline em si. Quando o personagem virou claramente artificial, o Seedance aceitou e gerou o clip.
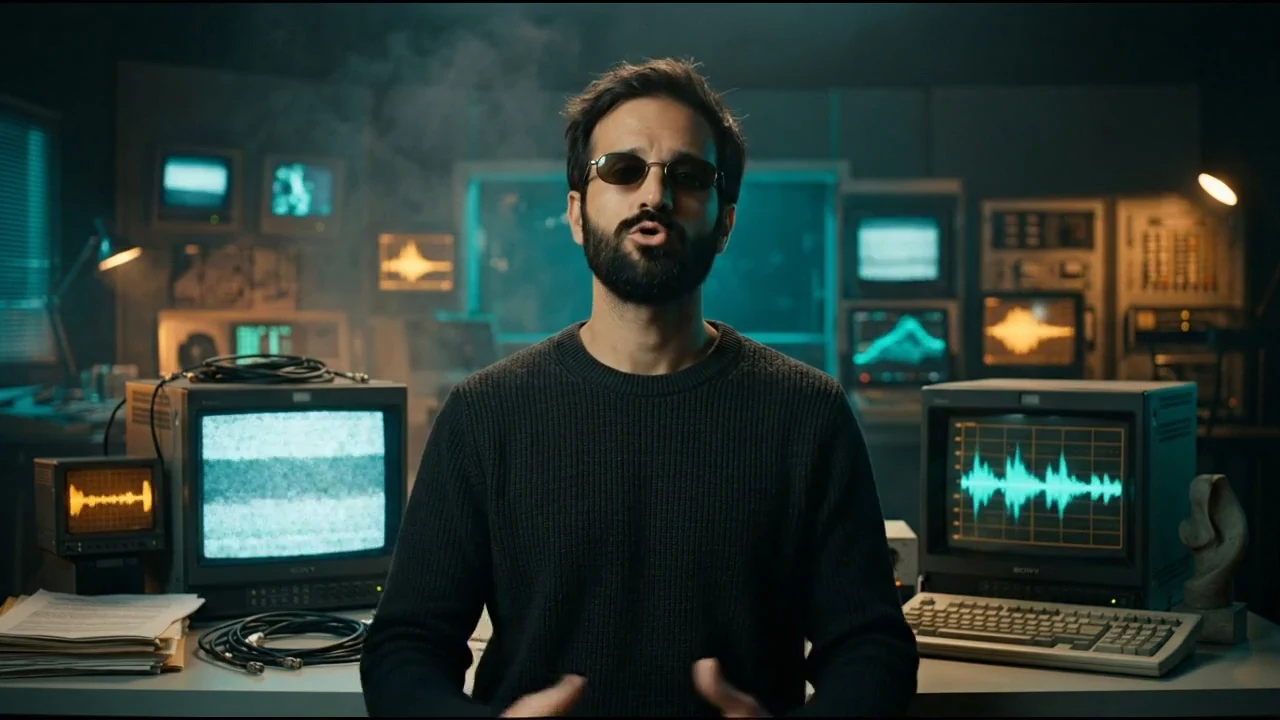
O Veo abriu um caminho mais útil: takes curtos, nativos, de quatro segundos, com fala embutida. Funcionou bem para esses blocos. Mas só até certo ponto. Quando tentei um take contínuo de oito segundos com o mesmo personagem realista, o modelo aceitou o job e depois reteve o output:
Video generation completed with no output (content may have been filtered)Isso tornou a gramática do meta-vídeo bastante clara. Fala em blocos curtos. Processo visual entre os blocos. Nada de monólogo longo. E nada de insistir em um único modelo para tudo.
3. Os prompts precisaram ficar mais concretos do que grandiosos
Uma parte pouco glamourosa dessa experimentação foi aprender que a qualidade do resultado estava menos ligada a um prompt “brilhante” e mais ligada a um prompt suficientemente específico, curto e operacional.
Um dos prompts que passou no Veo para o apresentador foi este:
Create a realistic cinematic presenter shot in a retro-tech studio.
A dark-haired bearded Brazilian man sits behind a desk, looking into camera
and speaking in Brazilian Portuguese in a calm, direct, intelligent tone.
He says: "Eu estou construindo este vídeo por blocos."
Keep the movement subtle and natural: stable face, coherent mouth motion,
calm breathing, small head motion, almost no hand movement.
Já para os blocos de processo no Seedance, o prompt precisou explicitar também o que não podia entrar. Quando os visuais ainda carregavam miniaturas humanas ou frames com rosto, o modelo voltava ao mesmo filtro de privacidade. A solução foi gerar composições completamente não humanas para só então animá-las.
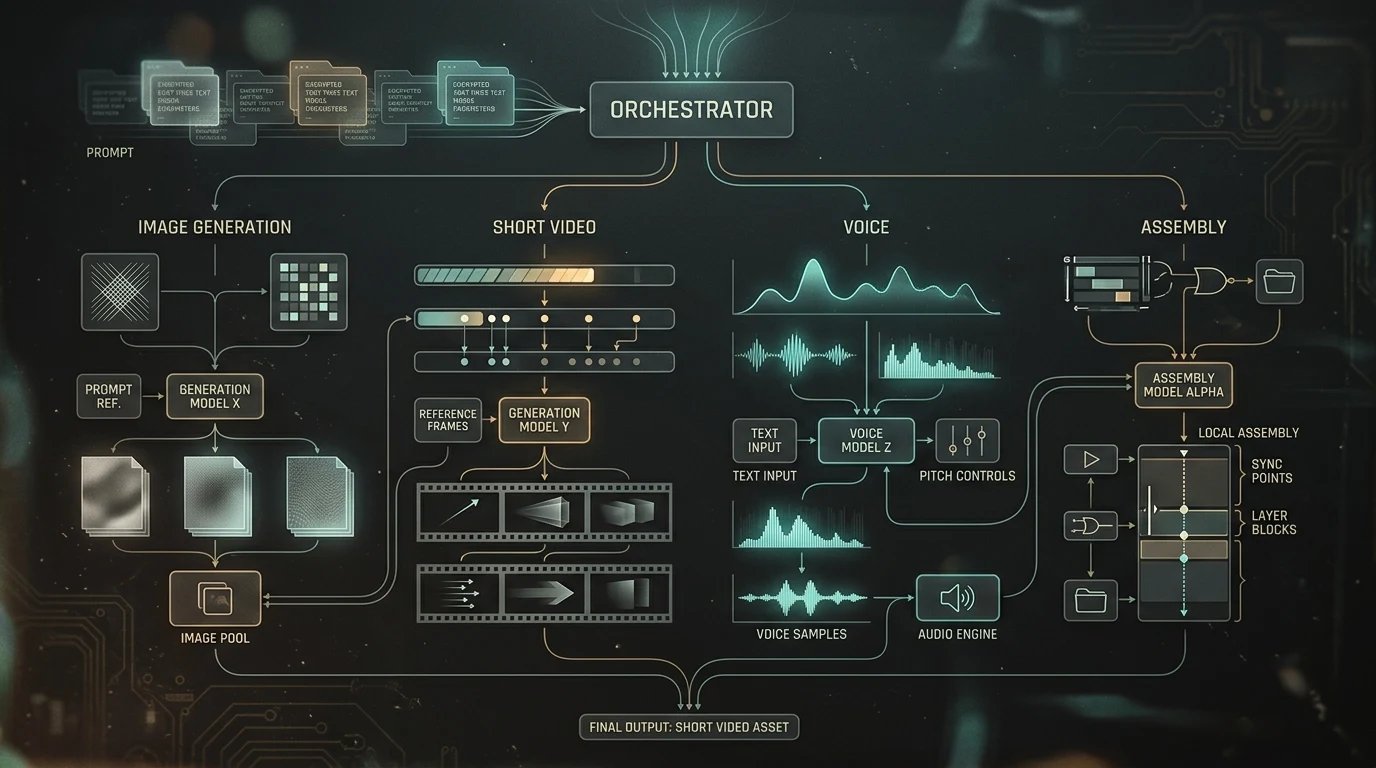
Animate this orchestration diagram with a sense of flow from image generation
to short video to voice to assembly. Nodes, waveforms, and placeholders
should move with clear directional logic and restrained cinematic motion.
No human figures.
4. Os visuais de processo precisaram virar material autoral
Eu não queria que a parte “explicativa” do vídeo fosse um slideshow de screenshots. Queria que ela parecesse parte da mesma linguagem do filme. Isso exigiu uma segunda família de imagens: boards editoriais, pseudo-interfaces, diagramas de orquestração, cards de prompt, módulos de áudio e montagem.
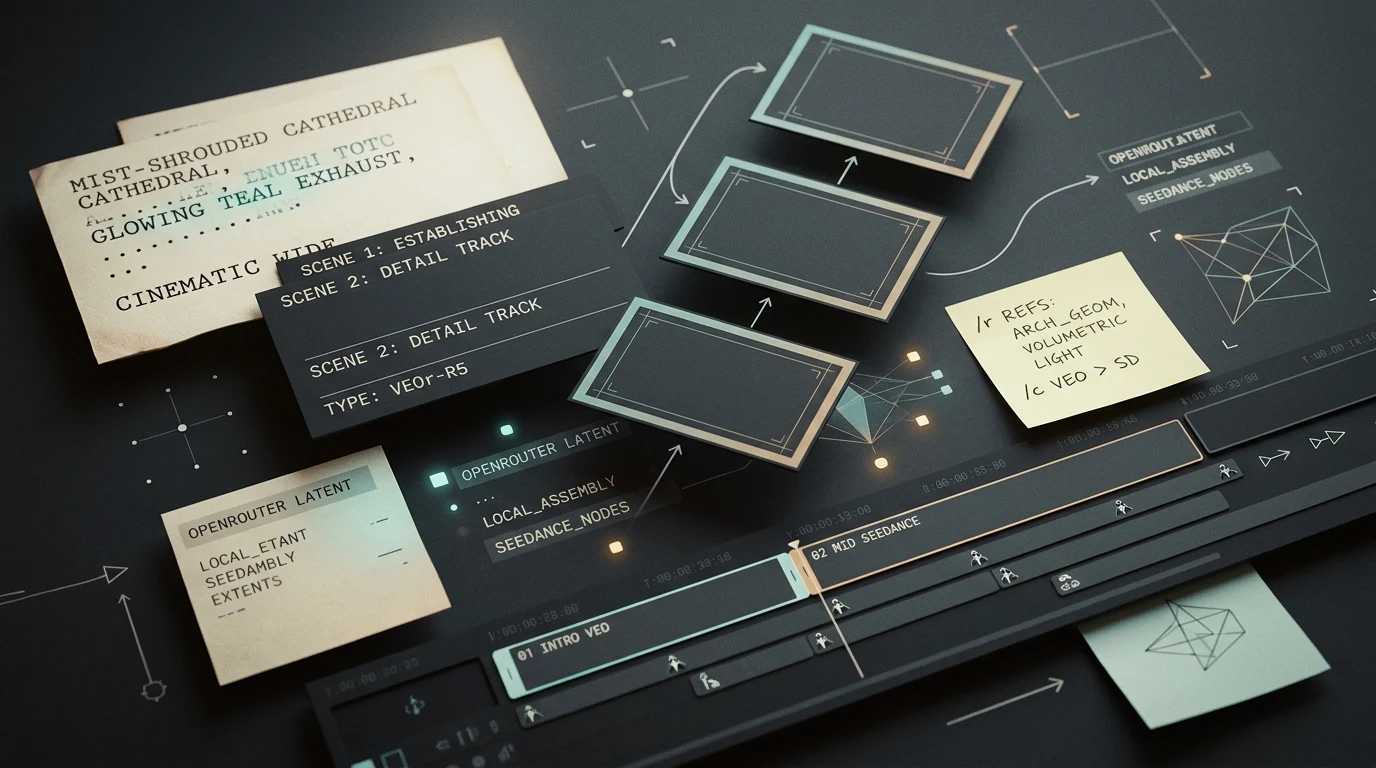
Essas imagens não são screenshots literais. São composições gráficas feitas para comunicar o processo como linguagem visual. E isso fez diferença. Quando ainda tentei usar motion simples via ffmpeg, o resultado resolvia o ritmo, mas não resolvia a ambição formal. O vídeo só começou a parecer coerente quando esses stills viraram pares de frame inicial e final e passaram pelo Seedance como clips de processo de fato.
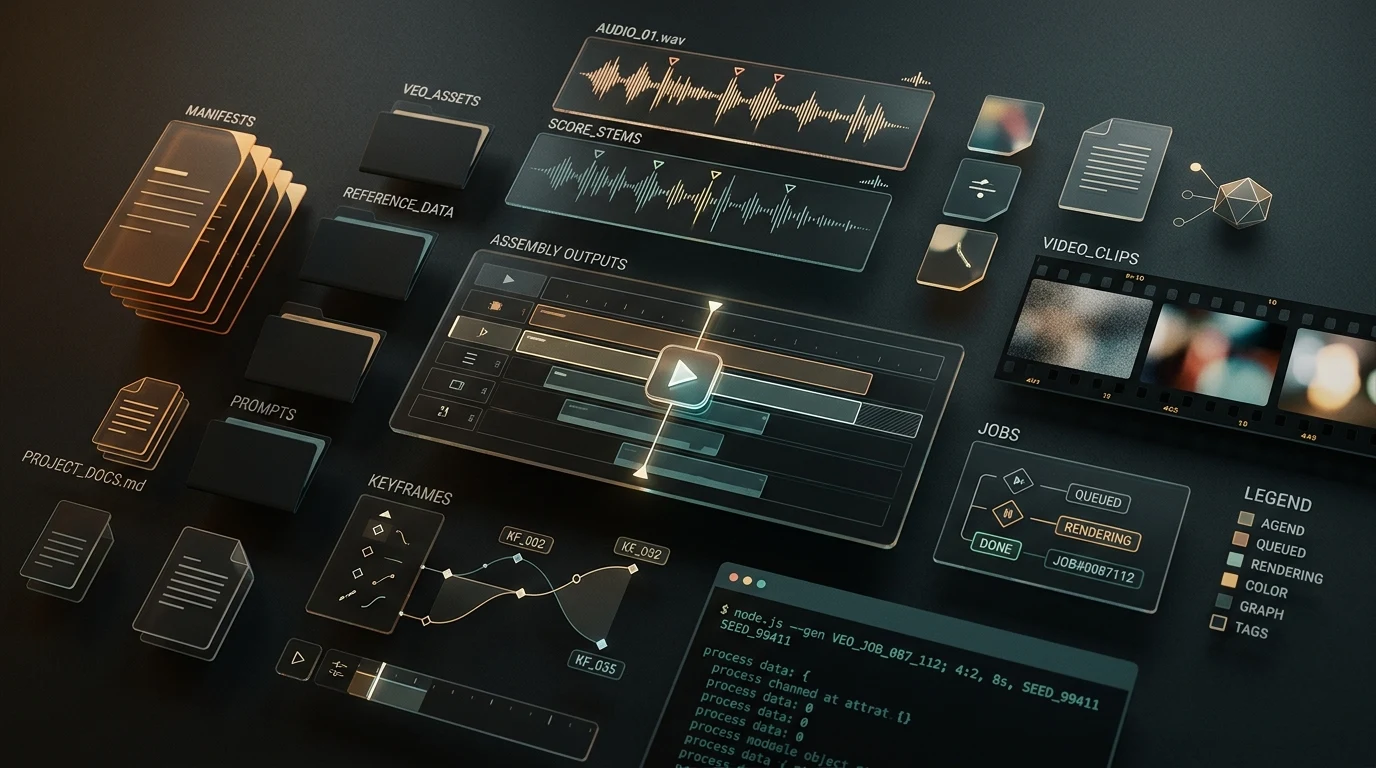
No fim, o ffmpeg voltou ao papel certo: não como gerador de “animação fake”, mas como ferramenta de montagem, muxagem e concatenação.
5. O custo exige método, não entusiasmo cego
Eu não descreveria esse custo como irrelevante. Em dólar, os números podem parecer pequenos à primeira vista. Em reais, eles já ganham outro peso. E, mais importante, eles deixam claro que geração de imagem e vídeo não pode ser tratada como brincadeira infinita de tentativa e erro sem método.
Fechando apenas o que ficou metrado nos artefatos locais:
- Entre andares: mínimo medido de US$ 3.8504
- Meta-vídeo do apresentador: mínimo medido de US$ 7.5994
- Total mínimo comprovável da experimentação: US$ 11.4498
Se eu olhar só para os dois cortes finais entregues, sem contar protótipos e desvios, o subtotal mínimo cai para US$ 8.6262. Ainda assim, isso já representa um investimento real para um experimento curto.
Esses números ainda têm uma ressalva importante: a geração de imagens não persistiu sempre o campo de custo nos artefatos locais. Então esse total é um piso confiável, não o valor absoluto final de tudo o que foi tentado.
A lição prática aqui é simples: usar bem esses modelos significa planejar melhor cada chamada. Quanto mais claro estiver o papel de cada ferramenta, do prompt e da referência antes de apertar o botão, menor a chance de transformar orçamento em ruído. O ganho não está em gerar mais. Está em gerar com mais intenção.
6. As limitações foram parte do aprendizado
Os limites encontrados não foram marginais. Eles praticamente desenharam o formato final do trabalho.
- O Seedance via OpenRouter bloqueou repetidamente faces realistas que pareciam pessoas identificáveis.
- O Veo funcionou melhor com takes falados curtos de quatro segundos.
- Takes mais longos ficaram mais vulneráveis a retenção ou filtragem do output.
- A consistência de voz nativa entre takes não é algo que eu controlava de fato no Veo.
- Parte do custo total de imagem ficou sem medição fechada em disco.
Paradoxalmente, essas limitações ajudaram. Elas empurraram o projeto para uma forma melhor: menos “vídeo contínuo gerado por um modelo só”, mais composição híbrida, montagem por blocos, stills fortes, processos visuais autorais e fala curta onde ela realmente precisava existir.
O que ficou
O resultado final não prova que já dá para “fazer qualquer vídeo com IA”. Prova algo mais útil: já dá para construir uma peça curta e coerente se você tratar cada modelo como um componente com forças e fraquezas específicas. O trabalho deixou de ser pedir um filme inteiro. Virou desenhar uma arquitetura de geração.
No meu caso, a forma acabou sendo esta: referências visuais, keyframes, OpenRouter como camada de acesso, Seedance para animações de processo e alguns planos mais gráficos, Veo para os takes falados e montagem local para amarrar o todo. Não foi um fluxo puro. Foi um fluxo pragmático. E foi justamente por isso que funcionou.
Mesmo assim, vale dizer com clareza: o resultado final ainda está longe de ser um resultado adequado ou refinado. Eu não busquei aqui um acabamento perfeito. A prioridade foi conseguir algum resultado funcional, aprender o que o fluxo aceita e o que ele bloqueia, e transformar isso em material real para estudo. Em breve quero voltar a essa linha de trabalho com testes mais profundos, mais controle de arte e um nível de entrega final bem melhor do que o que ficou nesta primeira rodada.
Ver os resultados no próprio post
Os dois vídeos finais abaixo estão em MP4 otimizado para web, com H.264, AAC e faststart, para tocar direto no player nativo do navegador sem depender de embed externo.
Outras Publicações
Paramos de desenhar telas. Aí o marketing pediu uma vista explodida
Deixamos de desenhar telas e passamos a prototipar em código. Quando o marketing pediu uma vista explodida da interface, a saída foi criar o stage-viewer: uma base real de cena 3D para a IA generativa refinar, em vez de recriar do zero.
A segunda corda
A linha de vida que impediu a queda de Mayk abre uma reflexão sobre trabalho, propriedade, tecnologia e as proteções que sustentam quem trabalha.
Há Quedas Por Vir
Um relato em cinco tempos sobre Há Quedas Por Vir, de Érica Storer e Sansa: shibari, um escritório suspenso e a queda que nunca chega.